ซิกนัล สโคป วิเคราะห์แอป
เราไม่ขายแพ็กเกจซอฟต์แวร์ — แต่ช่วยให้ทีมอ่านสัญญาณ crash และ error ในแอปได้ชัดขึ้นผ่านบทความและคำถามทางอีเมล
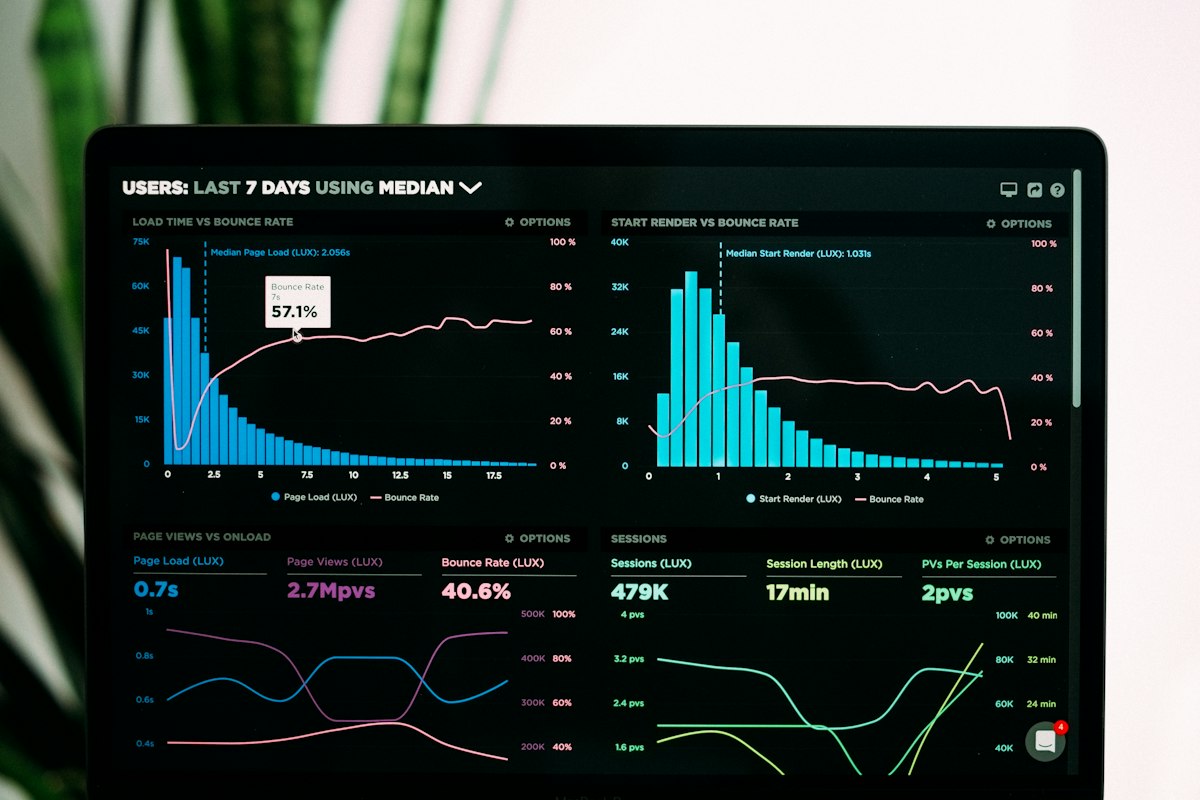
แนวโน้ม crash ไม่ใช่แค่ตัวเลขรวมรายวัน
หลายทีมยังมองเฉพาะยอด crash ต่อวัน แล้วสรุปว่า “ดีขึ้น” ทั้งที่ stack trace ซ้ำชุดเดิมหลังอัปเดต SDK
การวิเคราะห์แอปที่เน้น crash และ error trend ควรแยก build, อุปกรณ์, และเส้นทางผู้ใช้ก่อนตัดสินใจปล่อยเวอร์ชัน
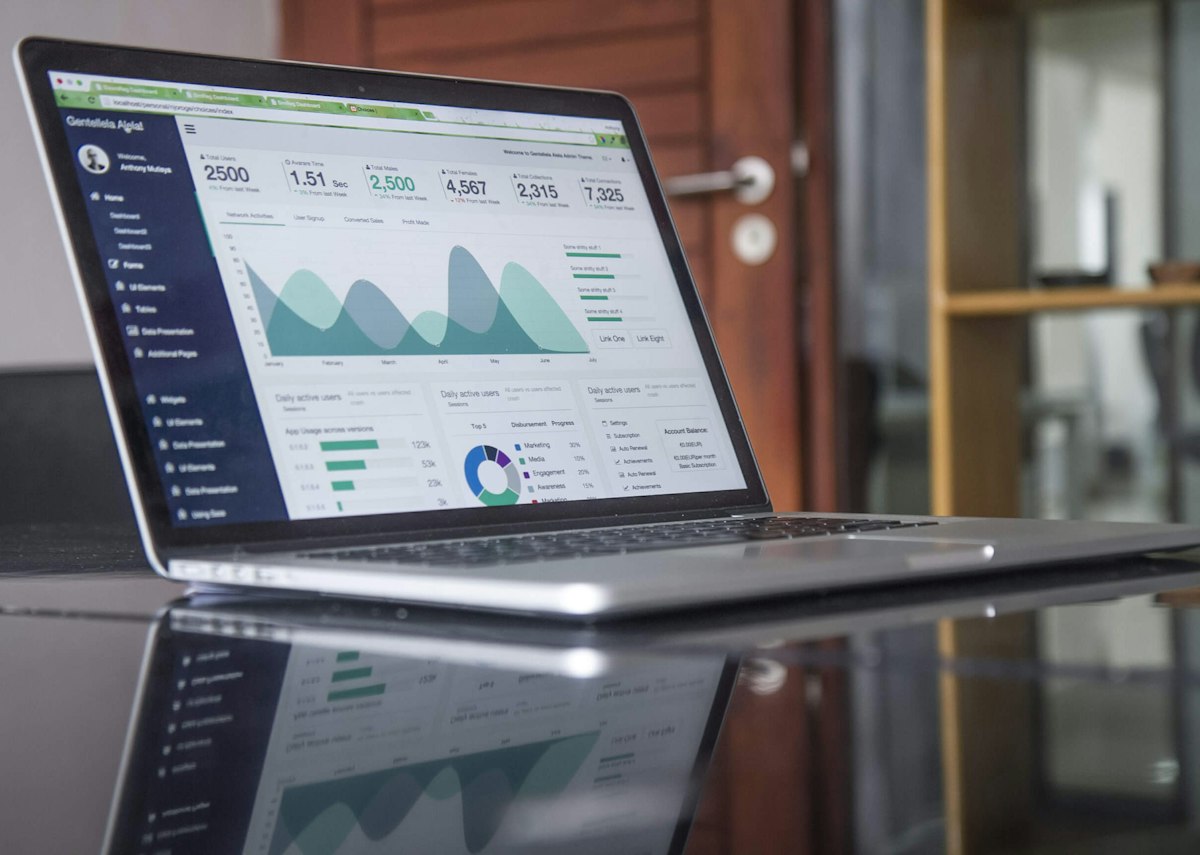
“ยอด error ลดลง” ไม่ได้แปลว่าแอปเสถียร — ถ้า error ถูกกลืนใน catch ว่างหรือถูกส่งออกนอกกลุ่มที่คุณติดตามมุมมอง myth-busting จากทีม ซิกนัล สโคป วิเคราะห์แอป
จัดกลุ่ม signal ก่อนตั้งคำถามกับทีมพัฒนา
เริ่มจาก fingerprint ของ crash (ชุดคลาส, เวอร์ชัน OS, หน่วยความจำ) แล้วจับคู่กับ session ที่นำไปสู่ force-close
error ที่ไม่ทำให้แอปหยุดทำงานยังมีค่า: rate ต่อ endpoint, timeout ต่อภูมิภาค, และ spike หลังเปิด feature flag
เนื้อหาบนเว็บไซต์นี้เป็นการศึกษา — ส่งคำถามผ่านแบบฟอร์มหากต้องการชี้แจงบริบทของโปรเจกต์คุณ
เหมาะสำหรับ ทีมที่มี crash reporting แต่ยังไม่มีรูปแบบรายงานประจำ sprint หรือต้องการภาษาไทยอธิบายแนวโน้ม error
อาจไม่ตรงกัน หากคุณมองหาแพลตฟอร์ม analytics แบบสมัครรายเดือนจากเรา — เราไม่ได้เสนอแผนราคาบนเว็บไซต์นี้
ดูแอปตัวอย่างที่ใช้สอนการอ่าน log
ชื่อพันธมิตรเทคโนโลยีในข้อมูลธุรกิจของเรา (เช่น IBM, Salesforce, Adobe, SAP, Cisco, Cloudflare, Stripe, Twilio, MongoDB, Atlassian, GitHub, Datadog, Snowflake, ServiceNow, Akamai, Unity) อธิบายระบบที่ทีมพัฒนามักใช้คู่กับเครื่องมือวิเคราะห์ — ไม่ได้แสดงว่าเราเป็นตัวแทนจำหน่ายหรือได้รับการรับรองจากแบรนด์เหล่านั้น
คำถามที่พบบ่อยเกี่ยวกับ crash analytics
- ต้องมีเครื่องมืออะไรก่อนเริ่มอ่าน trend?
- อย่างน้อยควรมี crash symbolication และช่องทางดึง error log ตาม build — ไม่จำเป็นต้องเป็นแบรนด์ใดแบรนด์หนึ่ง
- ทำไมต้องแยก fatal กับ non-fatal?
- ผู้ใช้บางครั้งยังใช้งานต่อหลัง non-fatal ในขณะที่ fatal ตัด session — การรวมเป็นตัวเลขเดียวบิดภาพความเสี่ยง
- ส่งคำถามแล้วจะได้รับอะไร?
- เราตอบทางอีเมลด้วยแนวทางอ่านข้อมูลเชิงการศึกษา ไม่ใช่ใบเสนอราคาหรือสัญญารับจ้างโดยอัตโนมัติ